NGINX Ingress Controller de F5 NGINX associé à la CRD ServiceMonitor de l’opérateur Prometheus permet de collecter beaucoup plus facilement et rapidement, avec Helm, les métriques des déploiements de NGINX Ingress Controller. Le chart Helm de NGINX Ingress Controller permet désormais de tirer immédiatement parti de votre infrastructure Prometheus et prometheus-operator existante. Vous pouvez ainsi déployer NIC et disposer d’emblée de métriques grâce à Prometheus ServiceMonitor. Cet article vous explique ce qu’est ServiceMonitor, comment l’installer et comment utiliser le chart Helm de NGINX Ingress Controller pour définir ces paramètres spécifiques.
ServiceMonitor Prometheus
La définition de ressource personnalisée (CRD) Prometheus ServiceMonitor vous permet de définir de manière déclarative comment un ensemble dynamique de services doit être surveillé. Les services surveillés sont définis à l’aide de sélecteurs d’étiquettes Kubernetes. Une organisation peut ainsi établir des conventions régissant la manière dont les métriques sont exposées. Lorsque ces conventions sont respectées, les nouveaux services sont automatiquement détectés et Prometheus commence à collecter les métriques sans qu’il soit nécessaire de reconfigurer le système. ServiceMonitor fait partie de Prometheus Operator. Ces ressources décrivent et gèrent les cibles de surveillance dont les métriques doivent être collectées par Prometheus. La ressource Prometheus se connecte à ServiceMonitor à l’aide d’un champ ServiceMonitor Selector. Prometheus peut facilement identifier les cibles marquées pour la collecte. Vous bénéficiez ainsi d’un contrôle et d’une flexibilité accrus pour exploiter les ressources ServiceMonitor dans votre cluster Kubernetes afin de surveiller des solutions telles que NGINX Ingress Controller. Pour simplifier les choses et fournir des métriques prêtes à l’emploi pour NGINX Ingress Controller, nous avons récemment ajouté à notre chart Helm la possibilité d’utiliser Prometheus ServiceMonitor. Il devient ainsi très facile d’activer les métriques afin que Prometheus commence à les collecter immédiatement après le déploiement de NGINX Ingress Controller. Pour utiliser cette fonctionnalité, nous devons ajouter un second service spécialement créé pour la collecte des métriques, auquel ServiceMonitor viendra « s’attacher ». Cela indique à Prometheus Operator quel service il doit surveiller (à l’aide des étiquettes figurant dans les métadonnées), afin qu’il sache quelles données collecter et où les récupérer. Voici à quoi pourrait ressembler un service pour NGINX Ingress Controller s’il était inclus dans des fichiers de déploiement ou des fichiers Helm :
apiVersion: v1
kind: Service
metadata:
  name: nginx-ingress-servicemonitor
  labels:
    app: nginx-ingress-servicemonitor
spec:
  ports:
  - name: prometheus
    protocol: TCP
    port: 9113
    targetPort: 9113
  selector:
    app: nginx-ingress
Les éléments ci-dessus feront partie du déploiement. Le label app: nginx-ingress-servicemonitor « connecte » le serviceMonitor afin que Prometheus puisse collecter les métriques. Voici un exemple de serviceMonitor qui serait associé au service ci-dessus nommé nginx-ingress-servicemonitor :
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: nginx-ingress-servicemonitor
  labels:
    app: nginx-ingress-servicemonitor
spec:
  selector:
    matchLabels:
      app: nginx-ingress-servicemonitor
  endpoints:
  - port: prometheus
Il est nécessaire de créer une ressource Prometheus configurée pour rechercher les ressources serviceMonitor, afin que Prometheus puisse déterminer rapidement et facilement les points de terminaison à interroger pour collecter les métriques. Dans l’exemple ci-dessous, cette ressource indique à Prometheus les éléments à surveiller dans la spécification. Ici, nous surveillons spec.serviceMonitorSelector.matchLabels:. Nous pouvons constater que Prometheus recherche, dans tous les espaces de noms, les matchLabels ayant pour valeur app.nginx-ingress-servicemonitor. Cela correspond à la ressource serviceMonitor qui sera déployée par les charts Helm du contrôleur Ingress NGINX et par Helm.
apiVersion: monitoring.coreos.com/v1
kind: Prometheus
metadata:
  name: prometheus
  labels:
    prometheus: prometheus
spec:
  replicas: 1
  serviceAccountName: prometheus
  serviceMonitorNamespaceSelector:  {}
  serviceMonitorSelector:
    matchLabels:
      app: nginx-ingress-servicemonitor
  resources:
    requests:
      memory: 500Mi
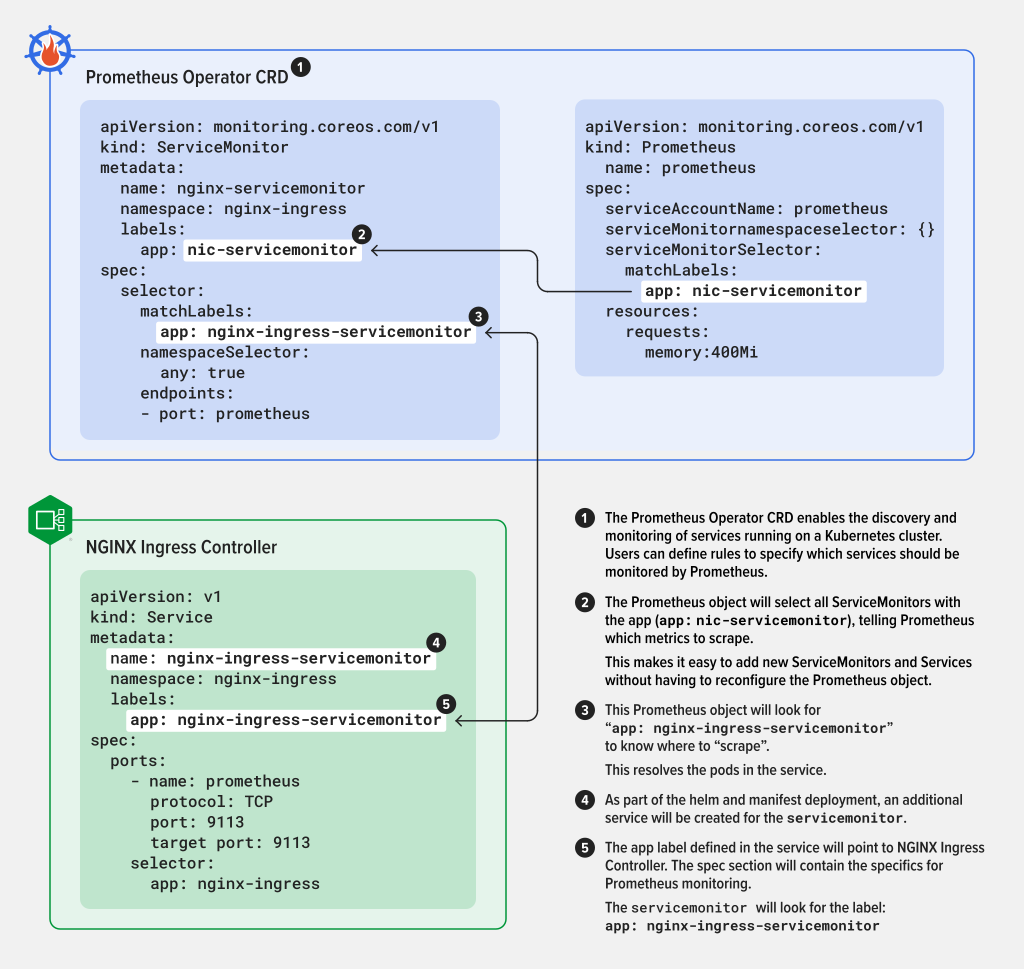
Voici un schéma qui relie les différents éléments :
Installation de Prometheus, de prometheus-operator et de Grafana
Nous allons utiliser prometheus-community/kube-prometheus-stack pour installer l’ensemble du déploiement. Cela installera prometheus, prometheus-operator et Grafana. Nous allons également préciser que nous souhaitons effectuer cette installation dans l’espace de noms monitoring afin de l’isoler. Voici comment procéder à l’installation avec helm : helm install metrics01 prometheus-community/kube-prometheus-stack -n monitoring --create-namespace
Créer et installer une ressource Prometheus
Une fois Prometheus et les CRD Prometheus installés dans le cluster, nous pouvons créer notre ressource Prometheus. En la déployant en amont, nous pouvons « préconfigurer » notre installation Prometheus avec les labels que nous utiliserons dans le chart Helm. Cette approche permet à Prometheus de commencer automatiquement à rechercher NGINX Ingress Controller et à collecter ses métriques. Notre ressource Prometheus sera déployée avant l’installation de NGINX Ingress Controller. Cela permettra au prometheus-operator de détecter automatiquement notre contrôleur Ingress NGINX après son déploiement et d’en collecter les métriques afin de les rendre rapidement disponibles.
apiVersion: monitoring.coreos.com/v1
kind: Prometheus
metadata:
  name: prometheus
  namespace: default
  labels:
    prometheus: monitoring
spec:
  replicas: 1
  serviceAccountName: prometheus
  serviceMonitorNamespaceSelector:  {}
  serviceMonitorSelector:
    matchLabels:
      app: nginx-ingress-servicemonitor
  resources:
    requests:
      memory: 500Mi
Notre exemple ci-dessus est un exemple simple. L’élément essentiel est la valeur spec.serviceMonitorSelector.matchLabels que nous avons spécifiée. C’est cette valeur que nous utiliserons lors du déploiement du contrôleur Ingress NGINX avec le chart Helm. Nous souhaitons fournir des métriques Prometheus prêtes à l’emploi. Pour ce faire, nous allons utiliser le chart Helm du contrôleur Ingress NGINX.
Modifications du chart Helm de NGINX Ingress Controller dans « values.yaml »
Nous pouvons examiner le fichier values.yaml du chart Helm. La section Prometheus mérite toute notre attention, car elle contient les éléments nécessaires pour activer Prometheus, créer le service requis et créer une ressource serviceMonitor. Dans la section Prometheus, plusieurs paramètres devraient apparaître : prometheus.service prometheus.serviceMonitor Nous allons activer ces deux paramètres afin de générer le service et le serviceMonitor requis lors de l’utilisation du chart Helm. Voici la section précise dans laquelle nous activons le service et serviceMonitor, et définissons les libellés dans la section serviceMonitor :
`servicemonitor` support was recently added to the NGINX Ingress controller helm chart.
prometheus:
  ## Expose NGINX or NGINX Plus metrics in the Prometheus format.
  create: true

  ## Configures the port to scrape the metrics.
  port: 9113

  secret: ""

  ## Configures the HTTP scheme used.
  scheme: http

  service:
    ## Requires prometheus.create=true
    create: true

  serviceMonitor:
    create: true
    labels: { app: nginx-ingress-servicemonitor }
En détaillant les valeurs ci-dessus :
prometheus:
  ## Expose NGINX or NGINX Plus metrics in the Prometheus format.
  create: true
Indique à Helm que vous souhaitez activer le point de terminaison Prometheus du NIC. Vous pouvez également définir un port, un protocole et un secret si nécessaire. En définissant la valeur de prometheus.service.create sur true, Helm créera automatiquement le service ServiceMonitor du NIC.
service:
    ## Creates a ClusterIP Service to expose Prometheus metrics internally
    ## Requires prometheus.create=true
    create: true
Enfin, nous devons créer le serviceMonitor. En définissant cette option sur true et en ajoutant les libellés appropriés, nous créerons et ajouterons les libellés correspondant à notre ressource Prometheus.
serviceMonitor:
    ## Creates a serviceMonitor to expose statistics on the kubernetes pods.
    create: true
    ## Kubernetes object labels to attach to the serviceMonitor object.
    labels: { app: nginx-ingress-servicemonitor }
Le label renvoie au nom indiqué dans service.labels : { app: nginx-ingress-servicemointor } En résumé, activez Prometheus afin d’exposer la fonctionnalité d’exportation Prometheus de NIC. Définissez un objet Service : c’est ainsi que le ServiceMonitor de Prometheus découvre les points de terminaison de l’exportateur Prometheus de NIC. Définissez un objet serviceMonitor afin d’indiquer au ServiceMonitor de Prometheus qu’il doit surveiller cet élément.
Nous pouvons maintenant installer NGINX Ingress Controller avec helm.
Une fois que nous avons modifié notre fichier « values.yaml », nous pouvons procéder à l’installation du contrôleur Ingress NGINX. helm install nic01 -n nginx-ingress --create-namespace -f values.yaml . Après avoir déployé le contrôleur Ingress NGINX, nous pouvons ouvrir le tableau de bord Prometheus et accéder au menu d’état. De là, nous pouvons consulter les vues des cibles et de la découverte de services. Dès que Prometheus détecte notre nouvelle ressource ServiceMonitor, il commence à interroger le point de terminaison et à collecter les métriques, qui apparaissent immédiatement dans le tableau de bord Prometheus.
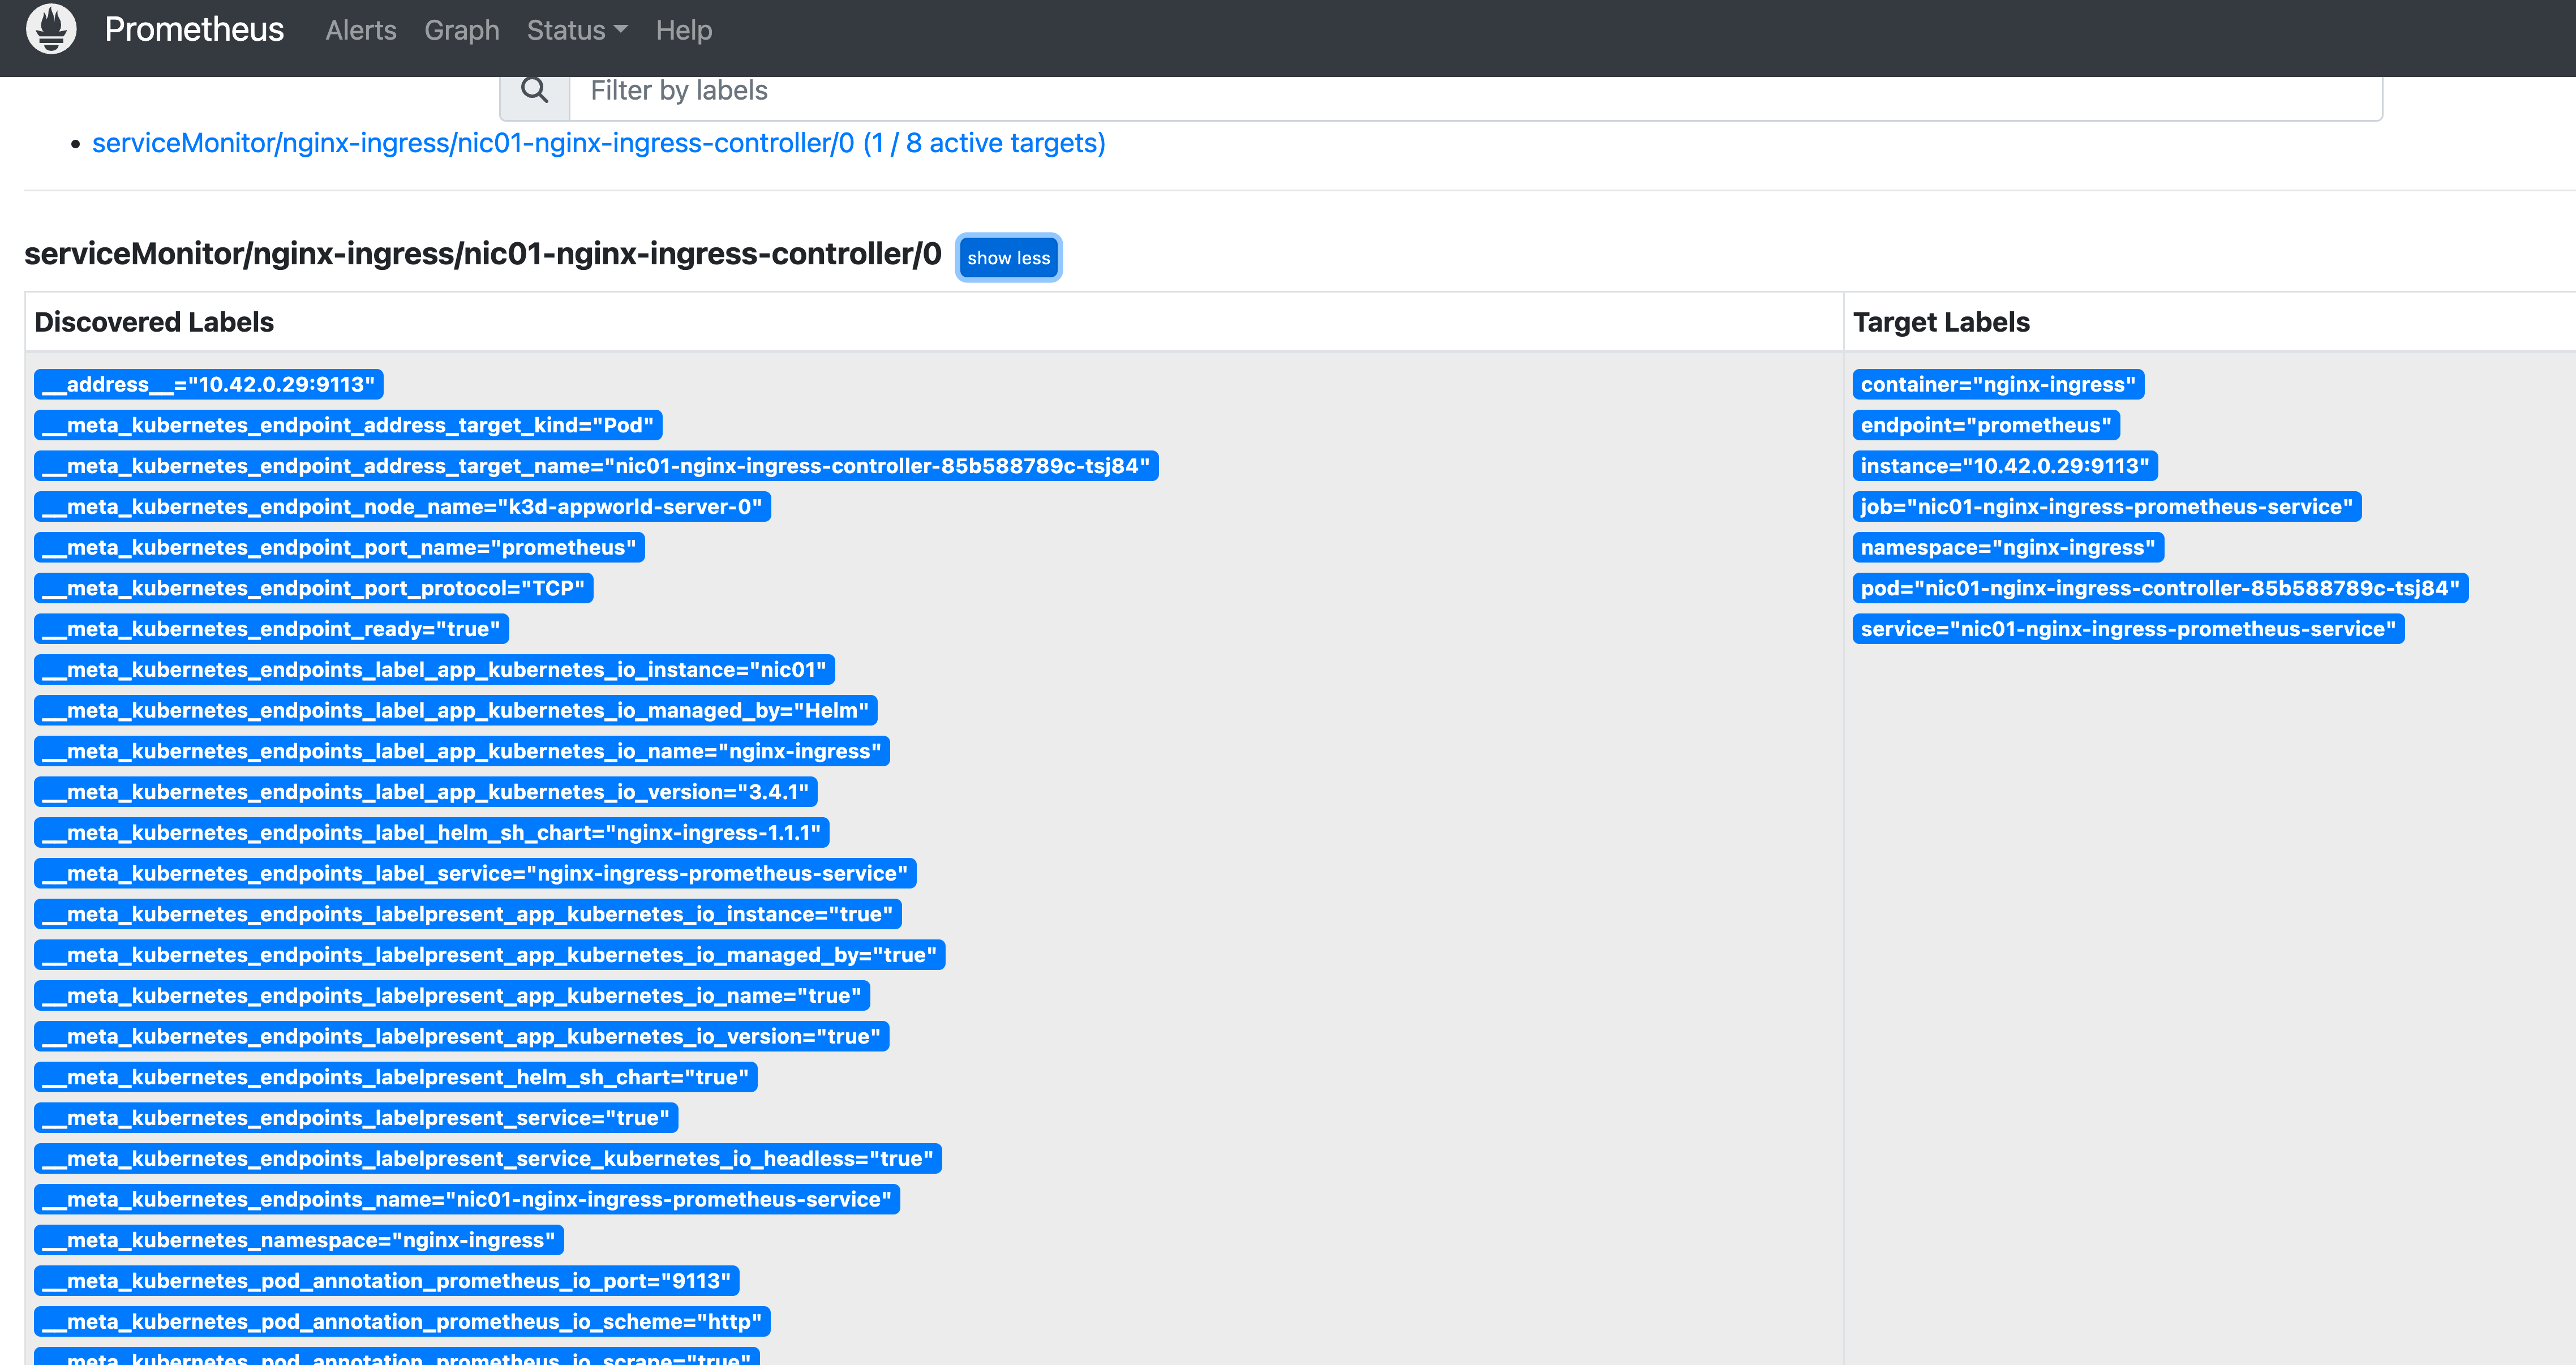
Figure 3 : cible Prometheus
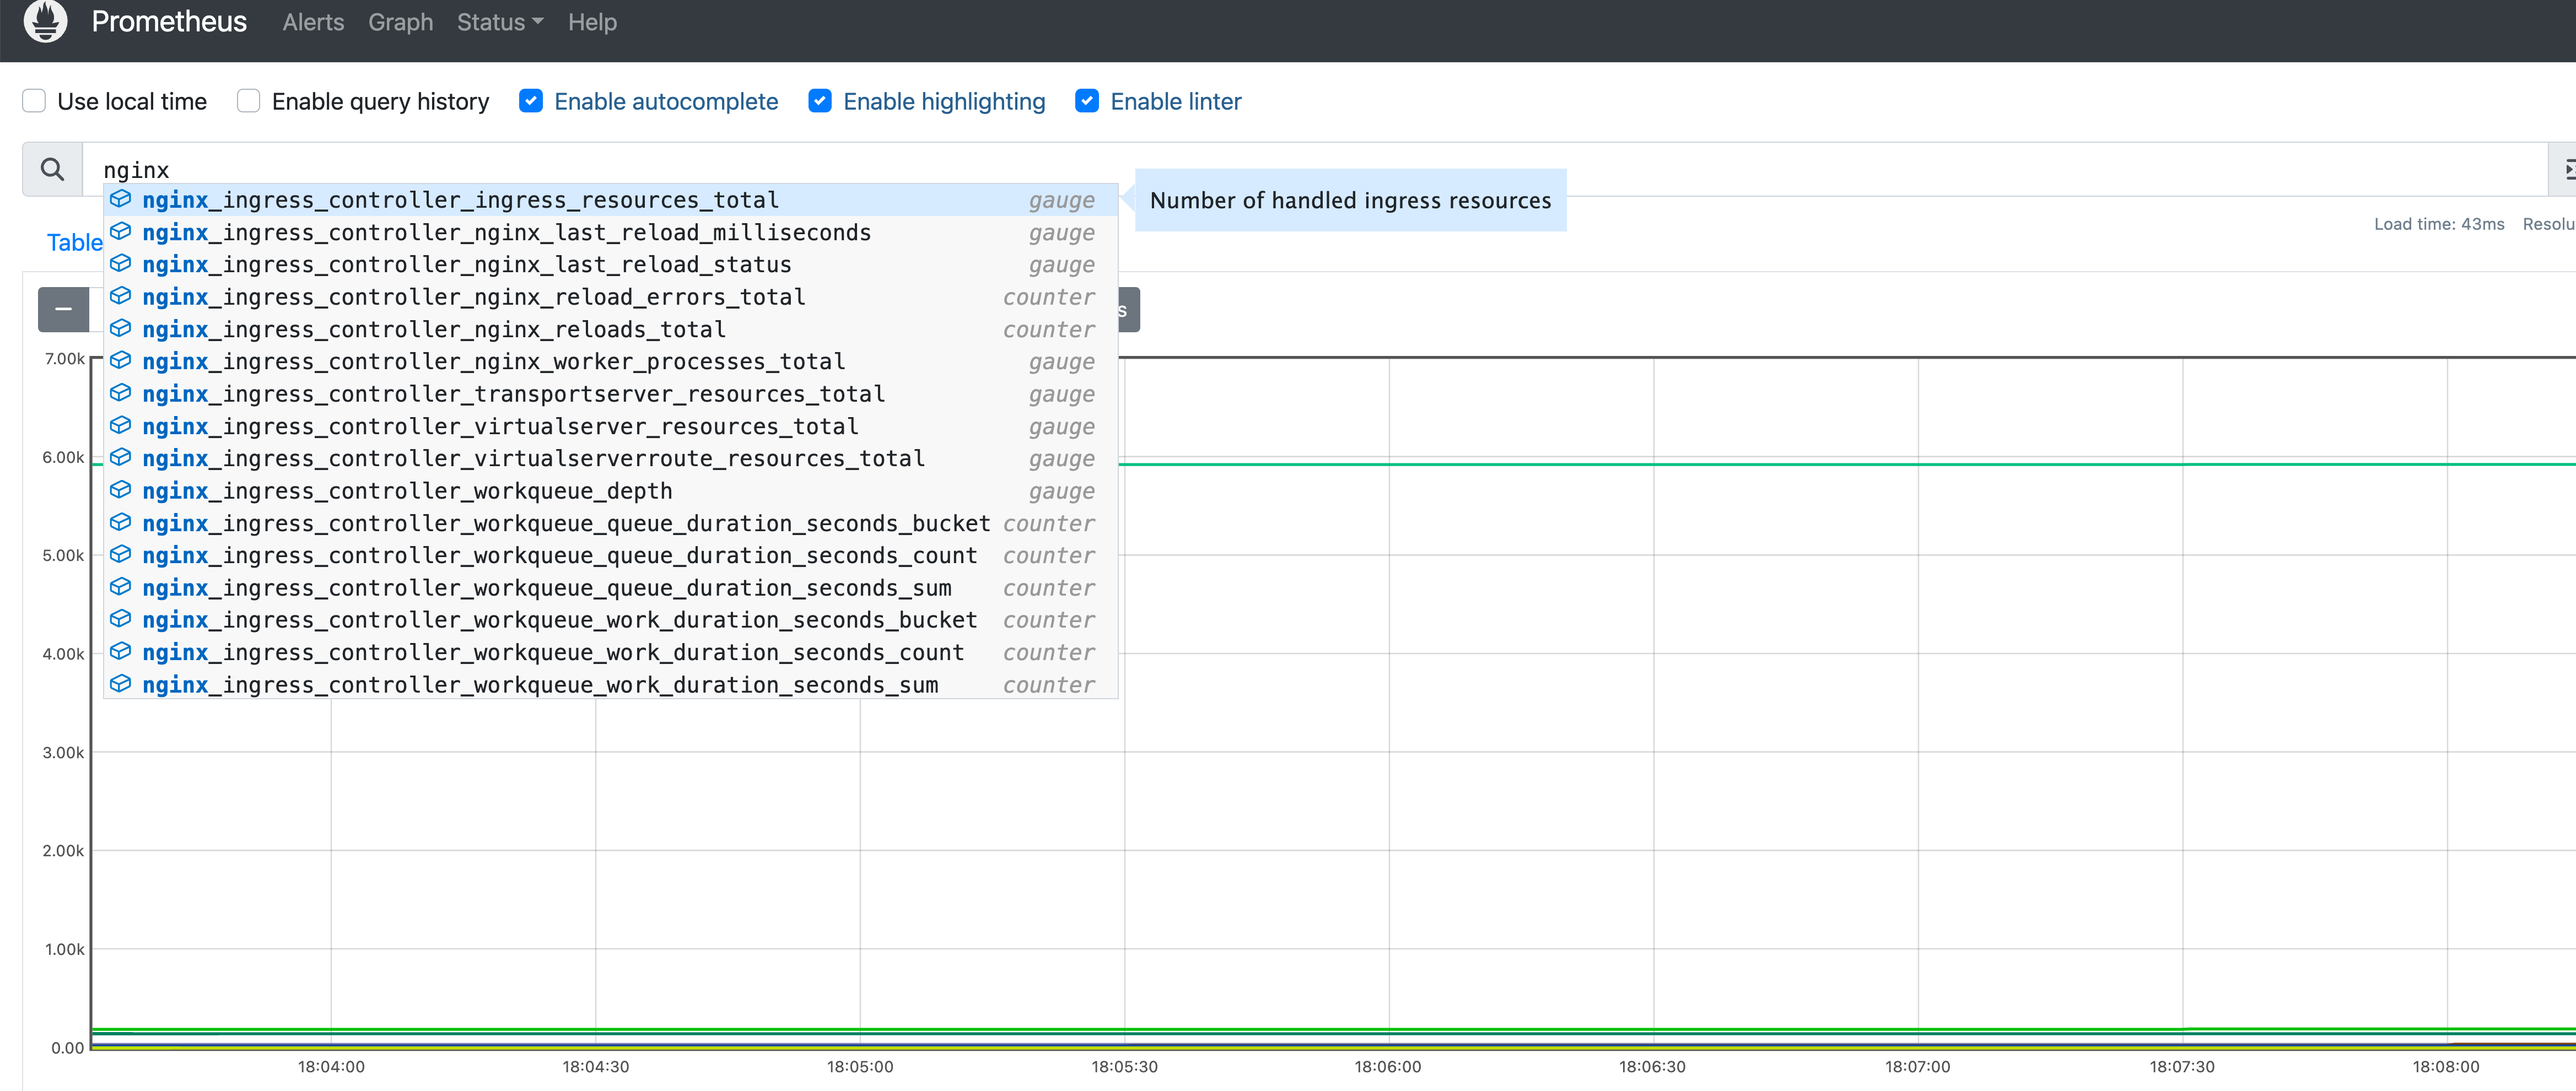
Nous pouvons constater qu’en utilisant des outils Kubernetes natifs tels que Helm et Prometheus, NGINX Ingress Controller facilite considérablement la collecte de métriques dès le début du déploiement, en fournissant des « métriques prêtes à l’emploi ». Voici des documents de référence pour installer prometheus-operator : https://prometheus-operator.dev/ https://github.com/prometheus-operator/prometheus-operator
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.