[Éditeur – Cet article a été mis à jour avec des informations sur les rapports révisés introduits dans rtapi version 0.2.0.]
Les API sont au cœur même des applications modernes et des architectures numériques en constante évolution. Selon le rapport d’Akamai sur l’état de la sécurité sur Internet, les appels d’API représentent 83 % de l’ensemble du trafic web. Dans le contexte actuel, où les consommateurs peuvent si facilement se tourner vers un concurrent numérique, il est primordial qu’ils bénéficient d’une expérience positive sur votre site ou votre application. La rapidité est particulièrement appréciée et repose en définitive sur des API réactives, robustes et adaptables. Si vous réussissez sur ce point — si votre API est plus rapide que celle de vos concurrents — les développeurs vous choisiront.
Selon le rapport d’IDC « Les API, facteurs déterminants de la réussite ou de l’échec des entreprises numériques », plus de 90 % des organisations s’attendent à une latence inférieure à 50 millisecondes (ms), tandis que près de 60 % d’entre elles tablent sur une latence de 20 ms ou moins. (La latence désigne le temps nécessaire à votre infrastructure d’API pour répondre à un appel d’API, depuis l’arrivée d’une requête au niveau de la passerelle API jusqu’au renvoi au client du premier octet de la réponse.)
Nous avons utilisé ces données, ainsi qu’une analyse de bout en bout du cycle de vie des API, pour définir une API en temps réel comme une API dont la latence est inférieure ou égale à 30 ms. En outre, ce seuil de latence de 30 ms doit être respecté jusqu’au 99e centile des requêtes traitées (ce qui signifie qu’en moyenne, seule 1 requête sur 100 prend plus de 30 ms). Pour en savoir plus, consultez notre article de blog sur l’évaluation comparative des performances des solutions de gestion des API.
Pour la plupart des entreprises, traiter les appels d’API aussi près que possible du temps réel représente un défi majeur, en particulier lorsqu’elles utilisent des passerelles d’API à l’architecture complexe comme points d’entrée vers leurs points de terminaison d’API. Alors, quelles sont les performances de vos API ? Sont-elles déjà suffisamment rapides pour être considérées comme fonctionnant en temps réel, ou doivent-elles être améliorées ? Votre produit vous semble-t-il un peu lent sans que vous parveniez vraiment à en déterminer la raison ? Peut-être ne savez-vous pas précisément quelle est la latence de vos API ?
Découvrez rtapi – un outil d’analyse comparative de la latence des API en temps réel, créé par NGINX, qui teste la réactivité de vos passerelles et points de terminaison d’API et génère des rapports que vous pouvez facilement diffuser et partager avec vos collègues. Deux formats de rapport sont disponibles : un PDF comprenant un graphique récapitulatif et un tableau au format ASCII présentant des métriques détaillées.
Exécution de rtapi
- Téléchargez le binaire
rtapidepuis GitHub en utilisant l’une des deux méthodes suivantes :- Si Golang est installé, exécutez cette commande :
$ go get github.com/nginxinc/rtapi- Si Golang n’est pas installé, accédez à github.com/nginxinc/rtapi/releases, téléchargez le fichier binaire correspondant à votre plateforme et rendez-le exécutable.
- Spécifiez un ou plusieurs points de terminaison d’API (cibles) que vous souhaitez interroger, au format JSON ou YAML, comme dans les exemples suivants. Nous vous recommandons d’enregistrer le contenu JSON ou YAML dans un fichier nommé endpoints.json ou endpoints.yml. (Pour JSON, vous pouvez également inclure les données dans la ligne de commande
rtapià l’étape suivante, en tant que paramètre de l’option--data.) Les seuls paramètres obligatoires pour chaque point de terminaison sonttarget.urlettarget.method. Si vous ne spécifiez pastarget.bodyettarget.header, ils restent vides. Si vous ne spécifiez pas un paramètre dans l’objetquery_parameters,rtapiutilise la valeur (par défaut) indiquée dans les exemples suivants. Exemple d’entrée JSON
[
  {
    "target": {
      "url": "https://www.example.com",
      "method": "POST",
      "body": "{\"id\":\"0\"}",
      "header": {
        "Content-Type": [
          "application/json"
        ]
      }
    },
    "query_parameters": {
      "threads": 2,
      "max_threads": 2,
      "connections": 10,
      "duration": "10s",
      "request_rate": 500
    }
  }
]- Exemple d’entrée YAML
- target:    url: https://example.com/api/id
    method: POST
    body: '{"id":"0"}'
    header:
      Content-Type:
        - application/json
  query_parameters:
    threads: 2
    max_threads: 2
    connections: 12
    duration: 10s
request_rate: 500- Exécutez la commande suivante, où
--fileindique le nom du fichier contenant la liste des points de terminaison d’API au format JSON/YAML et--outputindique le nom du rapport PDF à générer parrtapi. (Comme indiqué à l’étape 2, vous pouvez fournir les données JSON sur la ligne de commande : remplacez--fileendpoints.jsonpar--datasuivi de la chaîne JSON.)
$ rtapi --file endpoints.json --output report.pdf- Pour afficher dans le terminal le tableau des métriques au format ASCII, ajoutez l’option «
--print» à la place de l’option «--output» (ou en complément de celle-ci).
$ rtapi --file endpoints.json --printInterprétation du rapport PDF
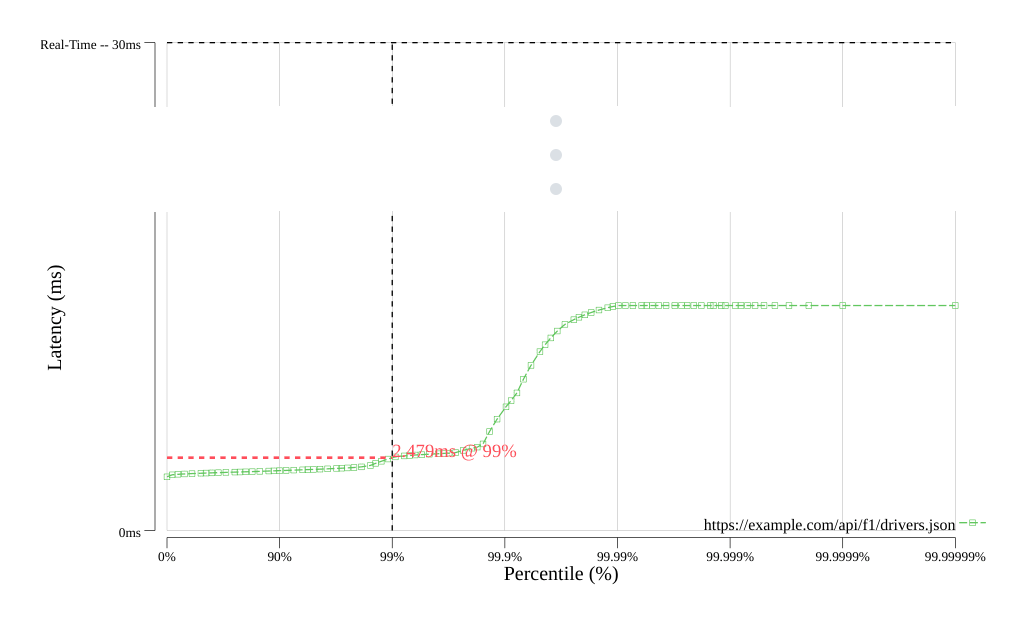
Le rapport PDF généré par rtapi contient un histogramme HDR de la latence de réponse semblable à celui présenté ci-dessous (provenant d’une passerelle d’API NGINX Plus configurée à l’aide du module de gestion des API de NGINX Controller). L’axe Y indique la latence en millisecondes, tandis que l’axe X indique la proportion d’appels traités en moins d’un temps de latence donné, exprimée sous forme de centile. (Dans l’exemple suivant, nous avons comprimé l’axe Y par souci de place.)
Pour mettre en évidence les résultats de votre API, les lignes en pointillés parallèles aux axes se croisent pour indiquer la latence mesurée de votre API au 99e percentile (99 % sur le graphique). Pour que votre API soit considérée comme fonctionnant en temps réel, la latence au point d’intersection doit être inférieure à 30 ms.
Comment NGINX peut-il vous aider ?
La latence de votre API est-elle inférieure à 30 ms ?
Si vous êtes comme bon nombre d’entreprises avec lesquelles nous échangeons, il y a de fortes chances que ce ne soit pas le cas. Avec de nombreuses solutions de passerelle et de gestion d’API, une latence de 100 ms est courante, et même une latence de 500 ms n’est pas si inhabituelle.
Nous pouvons vous aider à améliorer les performances de vos API : NGINX et NGINX Plus constituent la passerelle d’API la plus rapide du secteur et, associés à NGINX Controller, ils peuvent vous aider à acheminer, authentifier, sécuriser, réguler et mettre en cache les appels d’API en moins de 30 ms. Pour en savoir plus, échangez avec un expert NGINX et découvrez comment NGINX peut vous accompagner vers des API en temps réel sur nginx.com/real-time-api.
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.